ИИ ускорил развитие моделей Anthropic почти вдвое — самосовершенствование создаёт новые риски
Независимое исследование показало, что модели искусственного интеллекта компании Anthropic начали совершенствоваться почти в два раза быстрее, чем раньше, благодаря использованию ИИ для создания собственных более мощных версий. Это подтверждает опасения экспертов о том, что темпы развития ИИ могут опережать усилия по оценке связанных с ним рисков.
Источник изображения: Anthropic
Выводы некоммерческой организации METR (Model Evaluation and Threat Research), занимающейся вопросами безопасности ИИ, были опубликованы в четверг. Как пишет Reuters, эксперты называют эти данные одними из самых чётких доказательств того, что технологии вплотную подошли к
Для просмотра ссылки Войди или Зарегистрируйся, при котором ИИ сможет создавать новые версии себя полностью без участия человека.
В ходе 11-недельного исследования, проводившегося с августа по октябрь и опиравшегося на конфиденциальные материалы, интервью и данные о производительности ещё не выпущенных моделей, было установлено, что показатели эффективности моделей Anthropic при решении определённых задач растут в 1,9 раза быстрее, чем в период до октября 2025 года.
«По состоянию на октябрь 2026 года компания Anthropic, вероятно, повышает возможности своих моделей в решении конкретных задач примерно в два раза быстрее, чем это происходило в период с марта 2024 года по октябрь 2025 года. Эта оценка сопряжена с высокой степенью неопределённости. Нас не удивит, если фактический показатель ускорения окажется ближе к 1,5 или 2,5 от прежних темпов», — заявили в METR.
В отчёте также говорится, что на данный момент ИИ ещё не способен вносить полностью автономный и значимый вклад в ключевые этапы обучения моделей.
Исследователи Anthropic сообщают о резком росте продуктивности благодаря использованию ИИ для написания программного кода и проведения экспериментов. Согласно неофициальным опросам сотрудников, эффективность выросла примерно в 12 раз, однако в METR подчеркнули, что эти цифры не являются достоверными. Эксперты также выразили полную уверенность в том, что текущий скачок развития «не был связан с ускорением масштабирования вычислительных мощностей, используемых для обучения».
Технологический сдвиг происходит на фоне подготовки базирующейся в Сан-Франциско компании к выходу на биржу. Это может стать одним из крупнейших IPO в истории и серьёзной проверкой интереса инвесторов к компаниям в сфере ИИ, которые тратят миллиарды долларов на развитие данной технологии.
Вместе с тем перспектива рекурсивного самосовершенствования систем ИИ в последние месяцы стала поводом для предостережений со стороны исследователей в области искусственного интеллекта. Такие системы могут оказаться трудно поддающимися согласованию с человеческими целями, а также сложными в плане мониторинга и контроля, что потенциально создаёт экзистенциальную угрозу для человечества. Примечательно, что в сентябре сам генеральный директор Anthropic публично призывал замедлить темпы разработки передового ИИ.
Источник
Для просмотра ссылки Войди или Зарегистрируйся
Энергетическая дискриминация: ИИ тратит на запросы на некоторых языках до 180 раз больше энергии, чем на английский
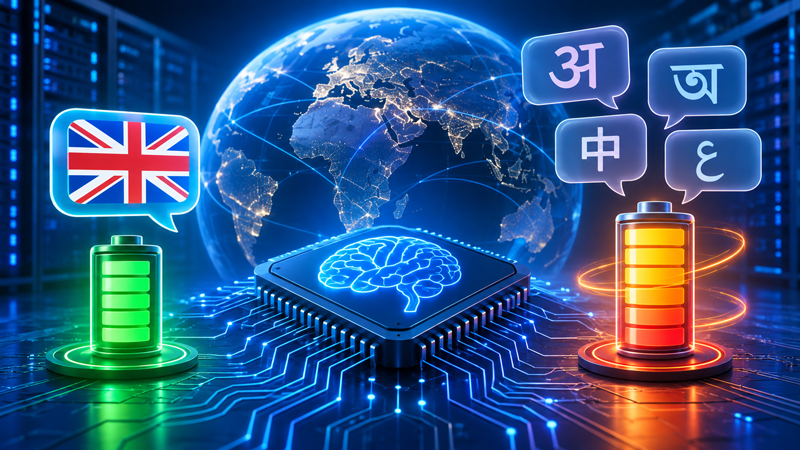
Учёные из Мичиганского университета (University of Michigan) показали, что обработка запросов искусственным интеллектом на разных языках требует существенно различающихся энергозатрат. В зависимости от языка и модели энергозатраты на обработку запросов на национальных языках могут превышать показатели для англоязычных запросов в 1,4–180 раз.
Источник изображения: ИИ-генерация ChatGPT/3DNews
Проверка ИИ на языковую и энергетическую дискриминацию охватывала 122 языка и пять вариантов моделей: Qwen 3 с 8, 14 и 32 млрд параметров (разработчик — Alibaba), Gemma 3 с 27 млрд параметров (Google) и Llama 3.1 с 8 млрд параметров . Для измерений использовалась разработанная исследователями система ML.Energy, позволяющая оценивать энергопотребление при выполнении вычислений ИИ-моделями. В качестве аппаратной платформы применялись два графических ускорителя NVIDIA — L40S и RTX 6000 Pro Blackwell.
Одной из основных причин разницы в энергопотреблении для обработки моделями ИИ запросов на разных языках оказалось увеличение количества токенов — минимальных единиц текста, на которые модель разбивает входные данные и формирует ответы. Токенизаторы, обученные преимущественно на латинском алфавите, менее эффективно обрабатывали некоторые другие системы письменности, разбивая слова на большее количество фрагментов.
Кроме того, для языков с ограниченными ресурсами для обучения модели нередко генерировали значительно более длинные ответы, иногда в 20–25 раз превышающие английские по числу выходных токенов. Увеличение количества токенов повышало требования к памяти и заставляло обрабатывать запросы меньшими пакетами, что снижало эффективность использования графических процессоров и увеличивало энергозатраты.
В исследовании максимальная разница в энергопотреблении на один выходной токен достигала 8,3 раза, а суммарные затраты на обработку одинакового набора запросов различались в 179 раз: от 17,6 кДж для английского языка до 3147 кДж для пушту.
Особенно заметна разница для языков, не использующих латиницу и представленных меньшим объёмом цифровых материалов для обучения ИИ. Например, генерация текста на хинди требует в среднем в 7,9 раза больше энергии, а на бенгальском — в 15,3 раза больше, чем на английском. Однако не стоит надеяться на латинский алфавит: для большинства западноевропейских языков также характерна разница в энергозатратах на обработку запросов, и по сравнению с английским она может быть двукратной.
Исследователи также обнаружили связь между энергозатратами и точностью ответов: языки, требующие больше вычислительных ресурсов, в среднем демонстрировали худшие результаты при выполнении тестовых заданий. Для проверки использовались тест Belebele на понимание прочитанного на 122 языках, математические задачи GSM8K и набор открытых пользовательских запросов LM-Arena. В дополнительных экспериментах англоязычные задания переводились на другие языки с помощью системы Meta
Для просмотра ссылки Войди или Зарегистрируйся No Language Left Behind.
По оценке исследователей, около 5,2 млрд человек в мире говорят на языках, обработка которых требует как минимум вдвое больше энергии, чем обработка английского языка. Это будет увеличивать стоимость использования коммерческих ИИ-сервисов для людей из разных языковых групп, поскольку многие поставщики рассчитывают стоимость услуг исходя из количества обработанных и сгенерированных токенов.
«Большинство людей захотят использовать модели ИИ, задавая вопросы на своих родных языках, и это будет неизбежным, поскольку ИИ внедряется во всё больше сфер жизни общества, но двойной “штраф” [за неанглийский] повышает вероятность того, что некоторые люди не смогут позволить себе ИИ, а компании будут неохотно предоставлять модели на определенных языках», — делают неутешительный вывод авторы работы.
В качестве возможных способов сокращения разрыва авторы предлагают создавать модели, специально оптимизированные для отдельных языков, направлять запросы к наиболее подходящим языковым моделям или предварительно переводить их на английский перед обработкой универсальной системой. Последний подход, по их мнению, применим при условии достаточно высокого качества перевода.
Ещё одно направление — расширение обучающих корпусов за счёт материалов на языках, которые пока недостаточно представлены в цифровом виде, в том числе с привлечением носителей этих языков.
Источник
Для просмотра ссылки Войди или Зарегистрируйся